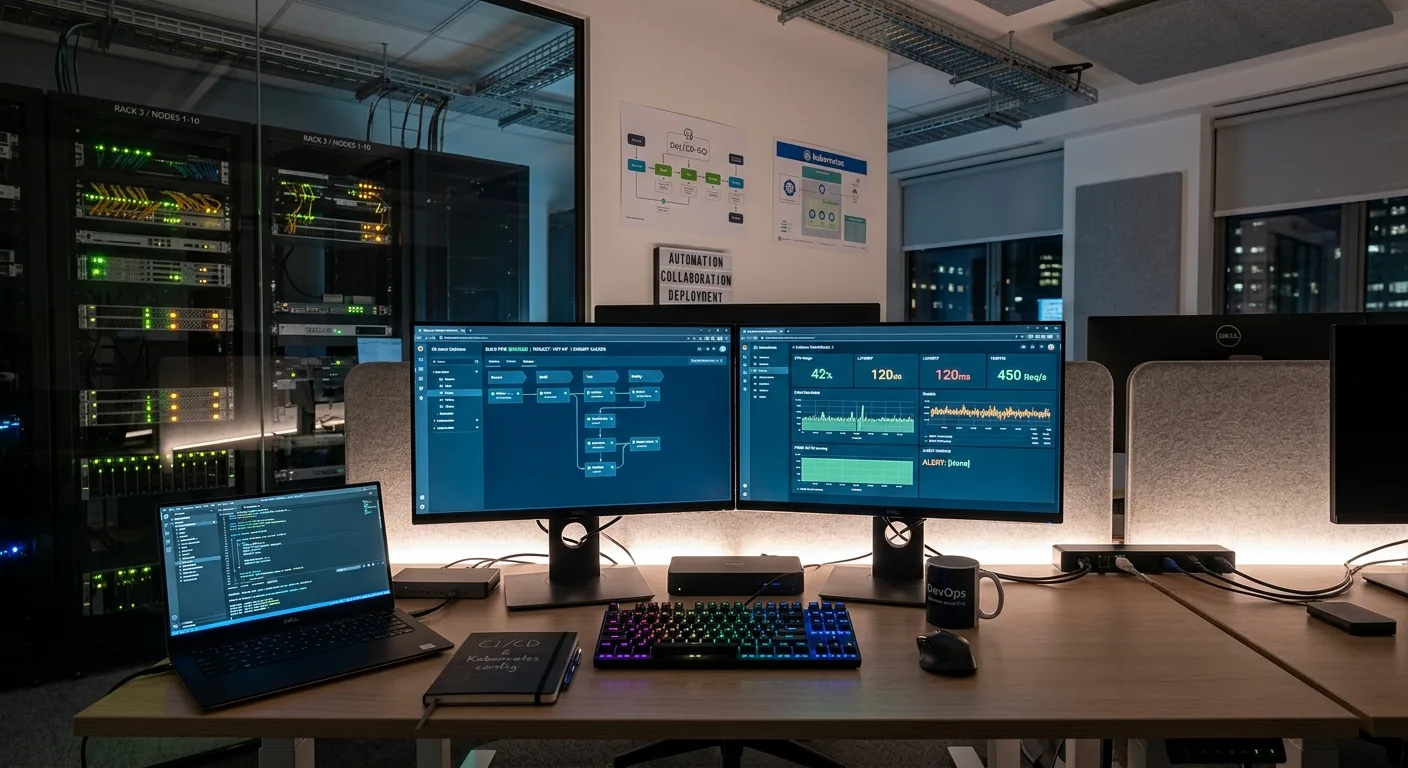
Značaj proaktivnog monitoringa i prikupljanja logova u DevOps ciklusu
Proaktivni monitoring i sistematično prikupljanje logova su stubovi stabilnog DevOps okruženja. Omogućavaju timovima da prepoznaju potencijalne probleme prije nego što eskaliraju u kritične incidente, smanjujući tako vrijeme zastoja i minimizirajući uticaj na korisnike. Kontinuirano praćenje pomaže u održavanju visokih performansi.
Integracija monitoringa i logovanja u svaki dio DevOps ciklusa – od razvoja, preko testiranja, do implementacije i operacija – obezbjeđuje sveobuhvatan uvid u stanje sistema. To omogućava bržu dijagnostiku, efikasnije rješavanje problema i kontinuirano poboljšanje softverskih proizvoda.
Alati za monitoring performansi aplikacija i infrastrukture
Za efikasan monitoring performansi, timovi se oslanjaju na niz specijalizovanih alata. Prometheus, u kombinaciji sa Grafanom, predstavlja moćan tandem za prikupljanje metrika i vizualizaciju podataka o infrastrukturi i aplikacijama u realnom vremenu. Ova kombinacija pruža detaljan pregled sistema.
ELK Stack (Elasticsearch, Logstash, Kibana) je još jedan popularan izbor koji omogućava centralizovano prikupljanje, obradu i analizu logova, kao i metrika. Ovi alati su ključni za dobijanje dubokog uvida u operativno stanje sistema i identifikaciju uskih grla.
Efikasan monitoring nije samo prikupljanje podataka, već umjetnost pretvaranja tih podataka u akcione uvide koji štite stabilnost i performanse naših sistema.
Strategije za centralizovano logovanje i analizu logova
Centralizovano logovanje je neophodno za efikasno upravljanje logovima iz različitih izvora. Umjesto da se logovi rasuti po pojedinačnim serverima, svi se prikupljaju na jednom mjestu, što olakšava pretragu, analizu i korelaciju događaja. Ova strategija pojednostavljuje dijagnostiku.
Korišćenje alata kao što su Logstash za obradu logova i Elasticsearch za indeksiranje omogućava brzu pretragu i analizu velikih količina podataka. Kibana zatim pruža moćne vizualizacije koje pomažu u identifikaciji trendova, anomalija i potencijalnih sigurnosnih prijetnji u sistemu.
Postavljanje alarma i automatizovanih odgovora na incidente
Samo prikupljanje podataka nije dovoljno; ključno je postaviti efikasne alarme koji obavještavaju timove o kritičnim događajima. Alarmi se konfigurišu na osnovu pragova performansi ili specifičnih obrazaca u logovima, osiguravajući da se na probleme reaguje brzo. Pravovremena obavještenja su presudna.
Automatizovani odgovori na incidente dodatno poboljšavaju otpornost sistema. To može uključivati automatsko skaliranje resursa, restartovanje neispravnih servisa ili pokretanje dijagnostičkih skripti. Ovakav pristup smanjuje ručnu intervenciju i ubrzava oporavak sistema nakon kvarova.